> For the complete documentation index, see [llms.txt](https://docs.cherryai.com.cn/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.cherryai.com.cn/docs/russian/pre-basic/providers/cherryai/free-glm46v.md).
# Zhipu GLM-4.6V
Пользователи Cherry Studio теперь могут через встроенный **CherryIN** бесплатно попробовать сервис **Zhipu GLM-4.6V**——визуальная флагманская модель, выпущенная Z.ai (Zhipu AI) в декабре 2025 года; архитектура MoE, 128K нативного мультимодального контекста и нативный мультимодальный вызов инструментов делают её предпочтительным выбором для задач понимания текста и изображений и мультимодальных агентных сценариев.
***
## Что такое GLM-4.6V?
GLM-4.6V — это новейшее поколение визуально-языковой модели серии Z.ai GLM-V, изначально поддерживающее единое моделирование текста + изображений и дополнительно расширяющее контекст и возможности вызова инструментов на базе GLM-4.5V.
* Архитектура: Mixture-of-Experts (MoE)
* Общее число параметров: 106B
* Активируемых параметров: около 12B
* Длина контекста: 128K токенов
* Открытая лицензия: MIT
* Дата выпуска: 8–9 декабря 2025 года
* Визуальный энкодер: поддержка изображений с несколькими разрешениями (до 4K)
В серию также входят **GLM-4.6V-Flash (9B)**— для локальных и низколатентных сценариев, бесплатно для коммерческого использования.
***
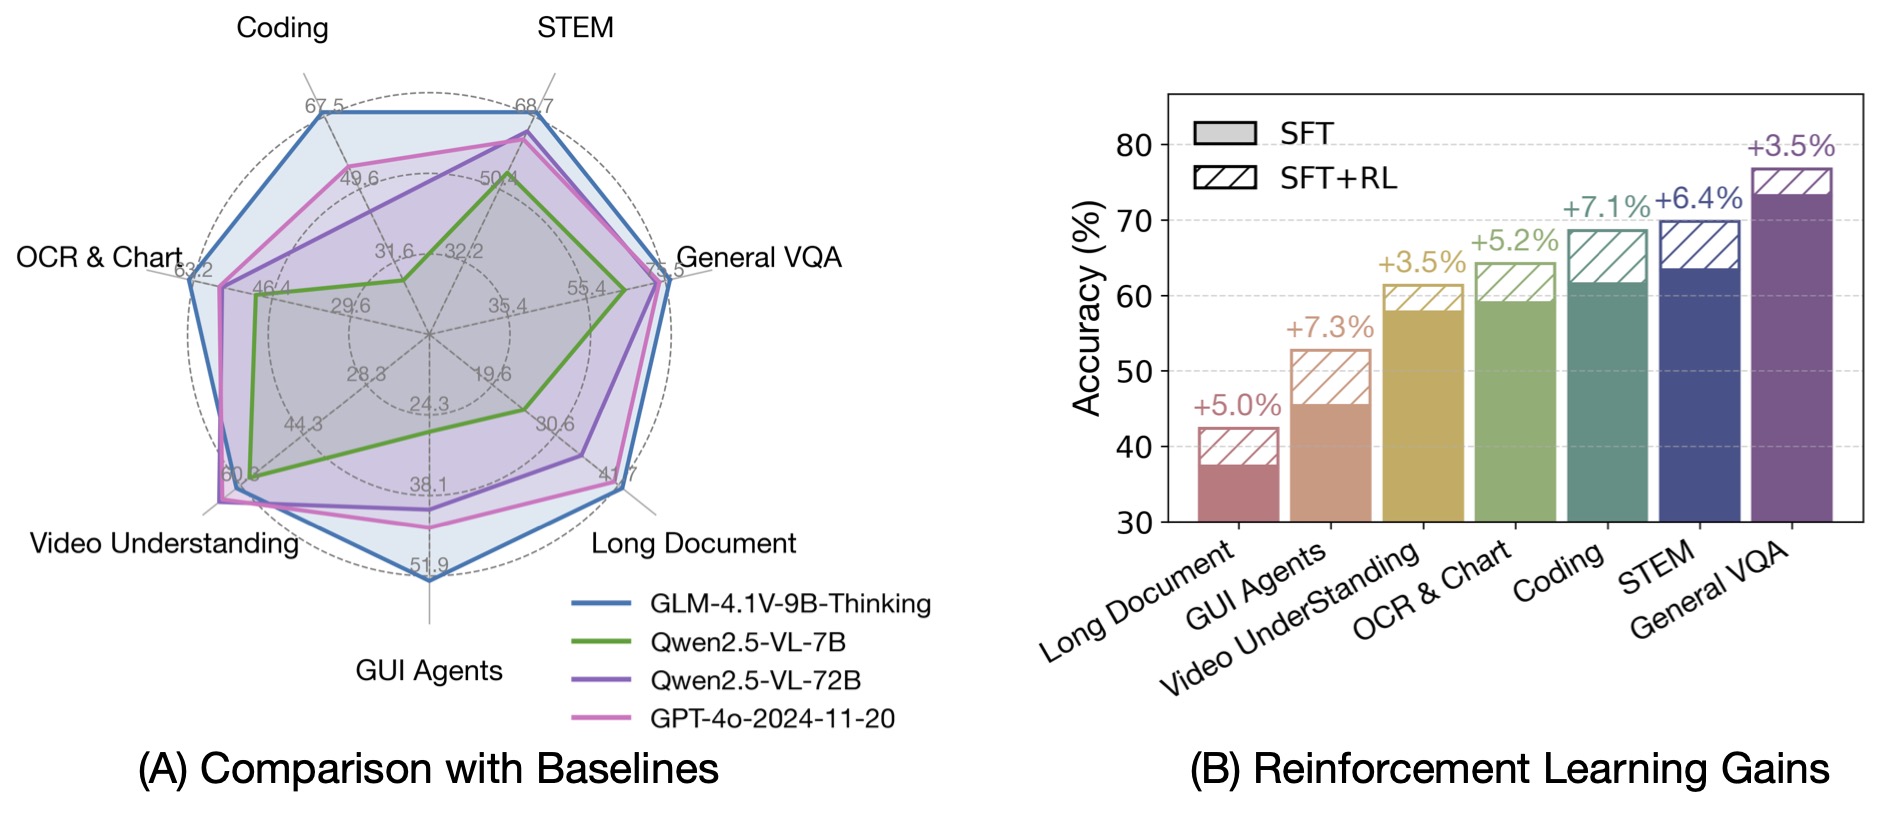
## Продолжает мультимодальную систему обучения серии GLM-V
GLM-4.6V унаследовала техническую линию GLM-4.1V-Thinking / GLM-4.5V и была дополнительно усилена в направлениях зрения и Agent:
1. **Нативное мультимодальное моделирование**:совместное обучение текста и изображений, поддержка смешанного ввода текста и изображений
2. **Расширение контекста**:контекст обучения расширен до 128K токенов; за один раз можно обработать примерно 150 страниц плотных документов, 200 страниц слайдов или 1 час видео
3. **Нативный мультимодальный вызов инструментов**:инструменты могут напрямую принимать и возвращать изображения; на основе расширенного протокола MCP мультимодальные артефакты обрабатываются по URL
4. **Усиление за счёт обучения с подкреплением**:используется масштабируемый RL-процесс серии GLM-V
***
## Нативная мультимодальность, ориентированная на реальные сценарии
Мультимодальные возможности GLM-4.6V охватывают повседневные и профессиональные сценарии:
* ✅ **Понимание форматированного текстового контента**:длинные документы, многостраничный текст и смешанная верстка текста с изображениями
* ✅ **Визуальный веб-поиск**:сетевой поиск и понимание с использованием визуального ввода
* ✅ **Воссоздание фронтенда**:генерация фронтенд-кода по макету дизайна или скриншоту UI
* ✅ **Мультимодальный анализ документов с длинным контекстом**:ввод целых PDF / презентаций / видео
* ✅ **Анализ диаграмм и таблиц**:извлечение структурированной информации
***
## Нативный мультимодальный вызов инструментов и возможности Agent
Одно из ключевых обновлений GLM-4.6V — это **«восприятие зрения → исполнимое действие»** замкнутый цикл: вызов инструментов изначально поддерживает изображения как вход и выход, что позволяет мультимодальным агентам внедряться в реальные бизнес-сценарии.
| Сценарий | Рекомендуемое использование | Пример |
| ------------------------------------------------- | ---------------------------- | --------------------------------------------------- |
| Простые вопросы и ответы по тексту и изображениям | Прямой диалог | «Что на этой картинке?» |
| Задачи средней сложности | Включить вызов инструментов | Чтение диаграмм с последующим поиском данных |
| Сложный мультимодальный Agent | Несколько инструментов + MCP | Скриншот → понимание → вызов API → генерация отчёта |
***
## Эффективный MoE, открыт и доступен
* ⚡ Селективная активация MoE: 106B параметров всего, активируется лишь около 12B
* 💰 Через CherryIN в Cherry Studio **Бесплатное использование**
* 🖥️ Весы, код инференса и инструменты MCP уже открыты в GitHub и Hugging Face, лицензия MIT
***
## Фокус на практических возможностях: мультимодальный помощник
GLM-4.6V в реальном использовании подходит для следующих сценариев:
* **Помощник по документам**:полное чтение и краткое изложение длинных документов, сканов и презентаций
* **Анализ данных**:распознавание и интерпретация диаграмм и скриншотов дашбордов
* **Фронтенд и дизайн**:генерация или изменение фронтенд-кода по скриншоту UI
* **Визуальный поиск**:сетевой поиск и объединение информации с использованием изображений
* **Мультимодальный Agent**:выполнение сложных задач с помощью инструментов браузера, выполнения кода, поиска и т. д.
***
## Как использовать в Cherry Studio?
1. Откройте Cherry Studio, перейдите в **Настройки → Сервисы моделей**.
2. Найдите **CherryIN** провайдера сервиса и включите его.
3. В списке моделей выберите **Zhipu GLM-4.6V**.
4. Вернитесь в чат, в верхнем выборе модели переключитесь на **GLM-4.6V** — и вы сможете прямо в диалоге загружать изображения для взаимодействия в формате текст + изображение.
> 💡 Подсказка: бесплатная квота моделей, предоставляемая CherryIN, финансируется официально Cherry Studio и подходит для повседневного использования и оценки; для production-среды рекомендуется использовать совместно с официальным API Z.ai (Zhipu).
***
📘 **Попробуйте GLM-4.6V от Zhipu прямо сейчас и откройте нативную мультимодальность и возможности визуального Agent!**
***
### Получить помощь и отправить отзыв
Если у вас в процессе настройки или использования возникнут какие-либо вопросы, баги или предложения по улучшению функций, пожалуйста, обратитесь к [Отзывы и предложения](/docs/russian/question-contact/suggestions.md) официальным каналам, указанным там.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.
Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:
```
GET https://docs.cherryai.com.cn/docs/russian/pre-basic/providers/cherryai/free-glm46v.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.